Stel, je hebt een webshop met 10.000 producten. Je wilt voorspellen welke producten volgende maand populair zijn zodat je je voorraad kunt aanpassen. Je kunt dat op gevoel doen. Je kunt historische verkoopdata in een spreadsheet analyseren. Of je kunt een computer die patronen laten ontdekken in je verkoophistorie en een voorspelling laten genereren. Dat laatste is machine learning.
Wat is machine learning concreet? Het is een onderdeel van kunstmatige intelligentie waarbij computers leren van data zonder dat iemand expliciet programmeert wat ze moeten doen. In plaats van regels schrijven (“als het december is, bestel meer winterjassen”) leert het systeem zelf welke factoren de verkoop beïnvloeden.
De term klinkt misschien abstract of technisch, maar machine learning zit al in tools die je waarschijnlijk dagelijks gebruikt. Je spamfilter, je Netflix-aanbevelingen, de routeberekening in Google Maps, de gezichtsherkenning op je telefoon. In dit artikel lees je hoe het werkt en waar het voor MKB-bedrijven concreet bruikbaar is. Voor de meeste MKB-vraagstukken is slimme automatisering praktischer dan een eigen model. Zie AI-automatisering.
Inhoudsopgave
Wat is machine learning precies?
Machine learning, letterlijk vertaald “machinaal leren”, is een methode waarbij algoritmen patronen ontdekken in data en op basis van die patronen voorspellingen of beslissingen maken. Het verschil met traditionele software is fundamenteel.
Wat betekent machine learning voor bedrijven concreet? Het komt erop neer dat software zelf patronen leert uit data en steeds beter voorspelt, denk aan welke klant dreigt op te zeggen of welke voorraad je volgende maand nodig hebt.
Traditionele software werkt met vaste regels. Een programmeur schrijft: “Als de temperatuur boven de 25 graden komt, zet dan de airco aan.” Die regel verandert niet, tenzij de programmeur hem aanpast.
Machine learning werkt anders. Je geeft het systeem een dataset met voorbeelden. Temperatuurmetingen, tijdstippen, het aantal aanwezige personen, de buitentemperatuur, de stand van de airco op elk moment. Het systeem analyseert die data en ontdekt zelf patronen. Misschien blijkt dat het niet alleen om temperatuur gaat, maar ook om luchtvochtigheid en het aantal personen. Die combinatie had een programmeur misschien niet bedacht.
Er zijn drie hoofdvormen van machine learning:
Supervised learning (begeleid leren) is een veelgebruikte vorm. Je geeft het systeem voorbeelden met het juiste antwoord erbij. “Dit is een spam-mail, dit is geen spam.” Na genoeg voorbeelden kan het systeem zelf bepalen of een nieuwe mail spam is. Dit gebruik je voor classificatie (is het A of B?) en regressie (wat is de verwachte waarde?).
Unsupervised learning (onbegeleid leren) werkt zonder voorbeelden met antwoorden. Het systeem zoekt zelf structuur in de data. Denk aan klantsegmentatie: het systeem groepeert je klanten op basis van koopgedrag, zonder dat je vooraf definieert welke groepen er zijn. Soms ontdekt het patronen die je niet had verwacht.
Reinforcement learning (bekrachtigingsleren) leert door te experimenteren. Het systeem probeert iets, krijgt feedback (beloning of straf) en past zijn strategie aan. Dit wordt veel gebruikt in robotica en gaming, en het kan ook dienen voor prijsoptimalisatie in webshops: Alibaba testte dat vanaf 2018 met dynamische prijzen voor duizenden producten op zijn webwinkel Tmall.
In de praktijk is supervised learning voor MKB-bedrijven het meest relevant. De data die je al hebt (verkoophistorie, klantgedrag, e-mailresponse) kun je inzetten om voorspellingen te doen, zodra die data op orde is.
Machine learning is de technologie die onder generatieve AI ligt. ChatGPT, Claude en soortgelijke tools zijn gebouwd op machine learning-modellen. Het verschil is dat generatieve AI specifiek gericht is op het maken van nieuwe content, terwijl machine learning een bredere set toepassingen omvat.
Hoe werkt machine learning?
Het proces achter machine learning volgt een vast patroon, ongeacht de toepassing.
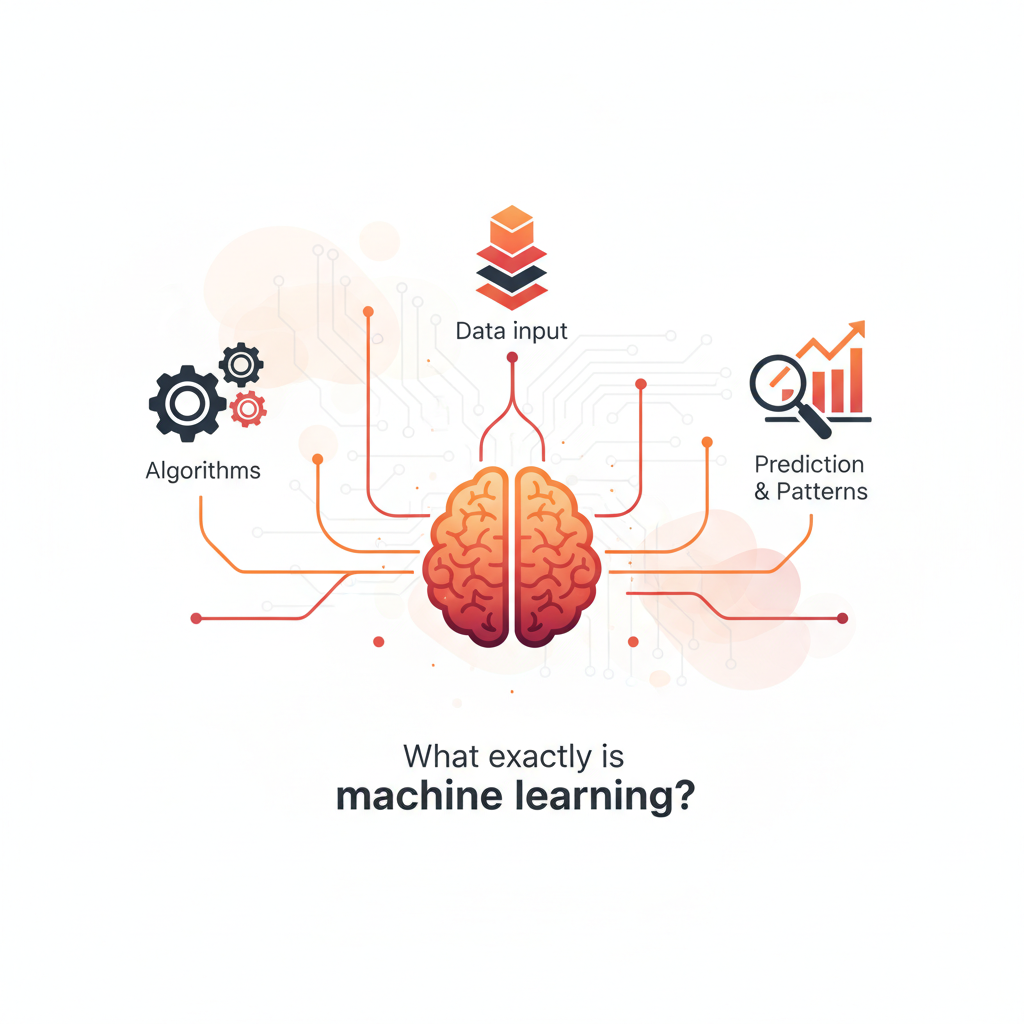
Het begint met data. Veel data. Een machine learning-model heeft voorbeelden nodig om van te leren. Hoe meer relevante data, hoe beter het model presteert. Een model dat klantverlooprisico voorspelt, heeft historische klantdata nodig: hoe lang waren ze klant, hoe vaak kochten ze, wanneer vertrokken ze, welke contactmomenten waren er?
Vervolgens wordt de data voorbereid. Dit is het minst spannende maar meest tijdrovende deel. Data opschonen, ontbrekende waarden aanvullen, formaten standaardiseren. In een enquête van Anaconda uit 2020 onder 2.360 mensen die met data science en machine learning werken, zeiden de deelnemers gemiddeld 45% van hun tijd kwijt te zijn aan het inladen en opschonen van data, nog voordat ze aan een model konden beginnen.
Dan komt het trainen van het model. Het algoritme doorloopt de data herhaaldelijk en past bij elke doorloop zijn interne parameters aan om de fout te minimaliseren. Stel dat het model de omzet van volgende week moet voorspellen. Het kijkt naar historische data, doet een voorspelling, vergelijkt die met de werkelijke omzet en past zijn berekening aan. Dit herhaalt het duizenden tot miljoenen keren.
Na het trainen wordt het model getest op data die het nog niet eerder heeft gezien. Dit is de controle: kan het model ook goede voorspellingen doen voor situaties die niet in de trainingsdata zaten? Als het model op de trainingsdata 95% nauwkeurig is maar op nieuwe data slechts 60%, is er een probleem. Het model heeft de trainingsdata “uit het hoofd geleerd” in plaats van de onderliggende patronen te begrijpen. Dit heet overfitting.
Als het model goed presteert op nieuwe data, wordt het ingezet. Het draait live, maakt voorspellingen op basis van nieuwe input, en wordt periodiek bijgewerkt met verse data.
Wat je als ondernemer moet begrijpen: machine learning is geen eenmalige actie. Het is een doorlopend proces. Data verandert, marktomstandigheden verschuiven, klantgedrag evolueert. Een model dat vandaag goed werkt, kan over zes maanden minder nauwkeurig zijn als het niet wordt bijgewerkt.
De drempel om met machine learning te beginnen is de afgelopen jaren flink gedaald. Waar je vroeger al snel een datascientist nodig had, kun je nu met platforms als AutoML in Google Cloud (sinds april 2026 onderdeel van Gemini Enterprise Agent Platform, de opvolger van Vertex AI), Amazon SageMaker AI of open-source bibliotheken als scikit-learn aan de slag. Maar onderschat de leercurve niet. Of schakel een bureau in dat je helpt met de eerste opzet.
Waarom is machine learning belangrijk voor bedrijven?
Machine learning lost een specifiek type probleem op: voorspellingen doen op basis van grote hoeveelheden data. En veel bedrijven hebben meer data dan ze denken.
Je CRM-systeem bevat klantinteracties. Je webshop logt elke klik en elke aankoop. Je boekhoudpakket heeft jaren aan financiële data. Je marketingtools weten welke e-mails werden geopend en welke niet. Al die data is grondstof voor machine learning.
Concreet levert machine learning drie dingen op voor MKB-bedrijven:
Betere voorspellingen. Een groothandel die met machine learning de vraag voorspelt, kan de voorraad nauwkeuriger afstemmen op wat klanten gaan bestellen. Minder overvoorraad, minder nee-verkoop. Hoeveel nauwkeuriger dat is, verschilt per situatie. In de M5-competitie, waarin teams de verkoop van Walmart voorspelden, waren de beste inzendingen (vooral machine-learningmethoden) ruim 20 procent nauwkeuriger dan de beste statistische vergelijkingsmethode. Per product per winkel was het verschil wel veel kleiner. Bij een grote voorraad kan ook een kleine verbetering geld schelen.
Slimmere personalisatie. Een webshop die productaanbevelingen baseert op machine learning in plaats van handmatige categorisering, kan klanten producten laten zien die beter passen bij wat ze eerder bekeken of kochten. Dat kan de gemiddelde orderwaarde verhogen. Amazon beschreef het algoritme achter zijn productaanbevelingen al in 2003.
Geautomatiseerde classificatie. E-mails sorteren, klantvragen categoriseren, documenten herkennen, facturen verwerken. Overal waar je nu handmatig sorteert of classificeert, kan machine learning taken overnemen, en bij grote aantallen kan de tijdsbesparing snel oplopen. In het klantportaal dat we voor Taxolution bouwden, leest en classificeert AI bijvoorbeeld de documenten die klanten insturen.
Maar er zijn ook reële beperkingen. Machine learning is niet geschikt als je weinig data hebt. Een model dat klantverlooprisico voorspelt, heeft minstens honderden, liefst duizenden voorbeelden nodig. Als je 50 klanten hebt, werkt een Excel-analyse beter.
Machine learning is ook geen vervanging voor domeinkennis. Het model ontdekt patronen, maar het begrijpt ze niet. Als je verkoopdata een seizoenspatroon toont, weet het model dat, maar het weet niet waarom. Die context moet van jou komen. De combinatie van menselijke expertise en machine learning levert doorgaans de beste resultaten op.
En eerlijk gezegd: voor veel MKB-toepassingen is machine learning overkill. Als je probleem oplosbaar is met een goede spreadsheet-formule of een if-then-regel, heb je geen machine learning nodig. Begin pas met machine learning als de complexiteit of de hoeveelheid data te groot wordt voor menselijke analyse.
Machine learning in de praktijk: voorbeelden voor MKB-bedrijven
Machine learning is niet voorbehouden aan techbedrijven. De vier voorbeelden hieronder zijn ter illustratie: zo kan het er in een mkb-bedrijf uitzien. Wat het jou oplevert, hangt af van je eigen data en processen.
Beginnen met AI is makkelijker dan je denkt
Benieuwd wat AI concreet voor jouw bedrijf kan betekenen?
Voorbeeld 1: Een webshop voorspelt retourzendingen
Situatie: Denk aan een modewebshop waar een flink deel van de bestellingen retour komt. Elke retourzending kost geld aan verzending en verwerking.
Toepassing: De webshop zet een machine learning-model in dat het retourrisico per bestelling voorspelt op basis van productcategorie, kledingmaat, klanthistorie, seizoen en betaalmethode. Bestellingen met een hoog retourrisico krijgen extra maatadvies en een gerichtere productomschrijving.
Wat je meet: het retourpercentage, vergeleken met de maanden ervoor, en wat elke voorkomen retour aan kosten scheelt. Bij veel bestellingen tikt ook een kleine daling flink aan.
Voorbeeld 2: Een verzekeringsadviseur voorspelt klantverlooprisico
Situatie: Denk aan een onafhankelijk verzekeringsadviesbureau met 3.500 klanten, waarvan er elk jaar een deel vertrekt. Elke klant die weggaat, moet het bureau met nieuwe klanten zien te vervangen, en werven kost tijd en geld.
Toepassing: Met een machine learning-model op basis van klantdata (polishistorie, contactfrequentie, claimgeschiedenis, looptijd) voorspelt het bureau welke klanten een hoog vertrekrisico hebben in de komende 90 dagen. Die klanten worden proactief benaderd met een persoonlijk gesprek.
Wat je meet: hoeveel klanten er per jaar vertrekken, vergeleken met de jaren ervoor. Zet de kosten van het model en de extra gesprekken af tegen wat een klant die blijft per jaar waard is. Dan zie je of het de moeite loont.
Voorbeeld 3: Een logistiek bedrijf optimaliseert routes
Situatie: Denk aan een koeriersdienst met 20 busjes die dagelijks routes door de regio rijdt. De routeplanning gebeurt handmatig door twee planners, op basis van ervaring en vaste patronen.
Toepassing: Het bedrijf zet een machine learning-systeem in dat routes optimaliseert op basis van verkeersinformatie, leveringsvensters, pakketgroottes en historische rijtijden. Het model leert welke routes op welke tijdstippen het efficiëntst zijn.
Wat je meet: de rijtijd per route, de brandstofkosten en de tijd die de planners aan de planning kwijt zijn, vergeleken met de periode ervoor. Ook een goed systeem kiest niet altijd een betere route dan een ervaren planner, dus kijk naar het gemiddelde over alle routes van een paar weken.
Voorbeeld 4: Een klantenservice prioriteert tickets automatisch
Situatie: Denk aan een SaaS-bedrijf met 800 klanten dat dagelijks 60 tot 80 supporttickets ontvangt. Urgente tickets zitten soms uren in de wachtrij, omdat ze handmatig worden gesorteerd.
Toepassing: Een machine learning-model deelt binnenkomende tickets automatisch in op urgentie en onderwerp, op basis van de tekst van het ticket, de klanthistorie en het type abonnement. Urgente tickets gaan direct naar senior medewerkers.
Wat je meet: hoe snel urgente tickets worden opgepakt, wat klanten van de afhandeling vinden en hoe vaak het model een ticket verkeerd indeelt. Ook een model maakt fouten, dus spreek af wie verkeerd ingedeelde tickets corrigeert.
Eerste stappen met machine learning
Je hoeft geen datascientist in te huren om met machine learning te beginnen. Maar je hebt wel een plan nodig.
Stap 1: Identificeer een concreet probleem. Niet “we willen iets met AI” maar “we willen voorspellen welke klanten gaan opzeggen” of “we willen binnenkomende e-mails automatisch categoriseren”. Hoe specifieker het probleem, hoe groter de kans op succes.
Stap 2: Inventariseer je data. Welke data heb je al? In je CRM, je webshop, je boekhouding, je ERP-systeem? Is die data schoon en gestructureerd? Hoeveel historische data heb je? Voor de meeste modellen heb je minstens een paar honderd voorbeelden nodig.
Stap 3: Start met kant-en-klare tools. Veel software die je al gebruikt, heeft machine learning ingebouwd. Google Analytics voorspelt conversiekansen. HubSpot scoort leads automatisch in de Enterprise-abonnementen. Mailchimp optimaliseert verzendtijden vanaf het Standard-abonnement. Begin met de tools die je al hebt voordat je iets nieuws bouwt.
Stap 4: Experimenteer laagdrempelig. Platforms als AutoML van Google Cloud en Amazon SageMaker Canvas bieden no-code interfaces waarmee je zonder programmeerkennis een basismodel kunt trainen. Het resultaat is niet altijd perfect, maar het geeft je een idee van wat mogelijk is.
Stap 5: Evalueer of het de moeite waard is. Meet het verschil. Is de voorspelling van het model beter dan je huidige aanpak? Hoeveel tijd of geld bespaart het? Als het antwoord “nauwelijks” is, bewaar machine learning voor een ander probleem.
Kortom: wat is machine learning? Het is software die patronen leert uit je eigen data en daarmee voorspellingen doet of beslissingen voorbereidt. Of het iets voor jouw bedrijf is, hangt af van hoeveel data je hebt en hoe vaak je dezelfde soort beslissing neemt.
Veelgestelde vragen over machine learning
Wat is het verschil tussen AI en machine learning? AI is het overkoepelende begrip voor systemen die taken uitvoeren waarvoor normaal menselijk denkvermogen nodig is. Machine learning is een methode om AI te realiseren: computers leren van data in plaats van geprogrammeerd te worden met regels. Alle machine learning is AI, maar niet alle AI is machine learning.
Heb ik veel data nodig voor machine learning? Dat hangt af van het probleem. Voor eenvoudige classificatietaken kunnen een paar honderd voorbeelden voldoende zijn. Voor complexe voorspellingen heb je duizenden of meer nodig. Als vuistregel: hoe meer variabelen je model gebruikt, hoe meer data je nodig hebt. Google noemt in zijn handleiding voor AutoML bijvoorbeeld als richtlijn minstens 50 rijen per variabele voor een classificatie en 200 per variabele voor het voorspellen van een getal (regressie).
Wat kost machine learning voor een MKB-bedrijf? De kosten lopen sterk uiteen. Gebruik je de machine learning die al in je tools zit, dan betaal je vaak niets extra, al zitten zulke functies soms alleen in de duurdere abonnementen. Laat je iets bouwen, dan hangt de prijs af van de complexiteit. Bij Red Factory begint een kleinere automatisering, bijvoorbeeld een workflow in n8n, vanaf ongeveer € 1.000. Bij een groter proces doen we eerst zelf de procesanalyse, en dan begint een implementatie vanaf € 5.000. Cloudplatforms als AWS en Google Cloud rekenen per gebruik: je betaalt onder meer voor het trainen van een model, het draaien ervan en de voorspellingen. Wat dat per maand kost, hangt dus af van hoe intensief je het gebruikt.
Kan machine learning mijn medewerkers vervangen? In de meeste MKB-situaties niet. Machine learning automatiseert specifieke taken, niet volledige functies. Het sorteren van e-mails, het voorspellen van verkooptrends of het classificeren van documenten. Je medewerkers krijgen meer tijd voor werk dat menselijk oordeel vereist.
Is machine learning hetzelfde als deep learning? Nee. Deep learning is een subtype van machine learning dat neurale netwerken met veel lagen gebruikt. Het is de technologie achter beeldherkenning, spraakherkenning en grote taalmodellen. Voor de meeste MKB-toepassingen is “gewone” machine learning voldoende en veel eenvoudiger te implementeren.
Hoe voorkom ik bias in machine learning? Door kritisch naar je trainingsdata te kijken. Als je data een scheefgetrokken beeld geeft, neemt het model die scheefte over. Een model dat is getraind op sollicitaties van de afgelopen 10 jaar, kan bestaande vooroordelen overnemen. Controleer je data op balans en test je model op eerlijkheid voor verschillende groepen.
Hoe lang duurt het om een machine learning-model te bouwen? Met een tool waarin machine learning al is ingebouwd, kun je meestal snel beginnen. Een maatwerkmodel duurt langer, omdat datavoorbereiding, training, testen en implementatie elk tijd kosten. Hoe lang precies, hangt vooral af van de staat van je data. Het onderhoud daarna is doorlopend.
Meer informatie vind je bij IBM over machine learning.
Tot slot
Machine learning is geen tovermiddel en het is niet voor elk bedrijf meteen relevant. Maar als je veel data hebt en regelmatig beslissingen neemt op basis van patronen in die data, is het de moeite waard om te verkennen. De drempel is lager dan ooit en de beschikbare tools worden steeds toegankelijker.
Wil je weten of machine learning iets voor jouw bedrijf kan betekenen? Neem contact op met Red Factory voor een oriënterend gesprek. We kijken samen naar je data, je doelen en de haalbaarheid.
Klaar voor een mega start?
Wij wel!
Stel al je vragen over onze producten, prijzen, implementaties, of iets anders. Wij zijn hier om jou te helpen!